Mon Home NOC : construire mon propre centre de supervision réseau
Un centre de supervision réseau domestique complet — collecte de métriques, monitoring de disponibilité, alerting temps réel, accès distant sécurisé et dashboard 100% maison — construit brique par brique sur deux Raspberry Pi, pour comprendre en profondeur chaque couche de la stack plutôt que de me reposer sur une solution clé en main.
Avancement du projet
- Prometheus + Node Exporter
- Uptime Kuma u2014 supervision de disponibilitu00e9
- Grafana u2014 visualisation avancu00e9e
- Premier dashboard central (Dashy)
- windows_exporter u2014 monitoring postes Windows
- Intu00e9gration calendrier
- VPN WireGuard
- Intu00e9gration Discord (alertes + suivi de projet)
- Dashboard personnalisu00e9 du00e9veloppu00e9 sur mesure
- Reconstruction du NAS domestique
🟩🟩🟩🟩🟩🟩🟩🟩🟩🟩 10/10 modules terminés
Le projet en une phrase
Un centre de supervision réseau domestique complet — collecte de métriques, monitoring de disponibilité, alerting temps réel, accès distant sécurisé et dashboard 100% maison — construit brique par brique sur deux Raspberry Pi, pour comprendre en profondeur chaque couche de la stack plutôt que de me reposer sur une solution clé en main.
Pourquoi ce projet
Je voulais reproduire chez moi les principes d’un vrai NOC d’entreprise : visibilité centralisée sur toute mon infrastructure (serveurs, postes de travail, connectivité), alerting proactif en cas d’incident, et supervision accessible de manière sécurisée même en déplacement. Plutôt que d’installer un outil tout-en-un, j’ai choisi d’assembler la stack composant par composant — et, une fois les fondations solides, de développer mon propre frontend de supervision plutôt que de m’arrêter à un dashboard générique.
Architecture générale
L’infrastructure repose sur deux Raspberry Pi aux rôles bien séparés :
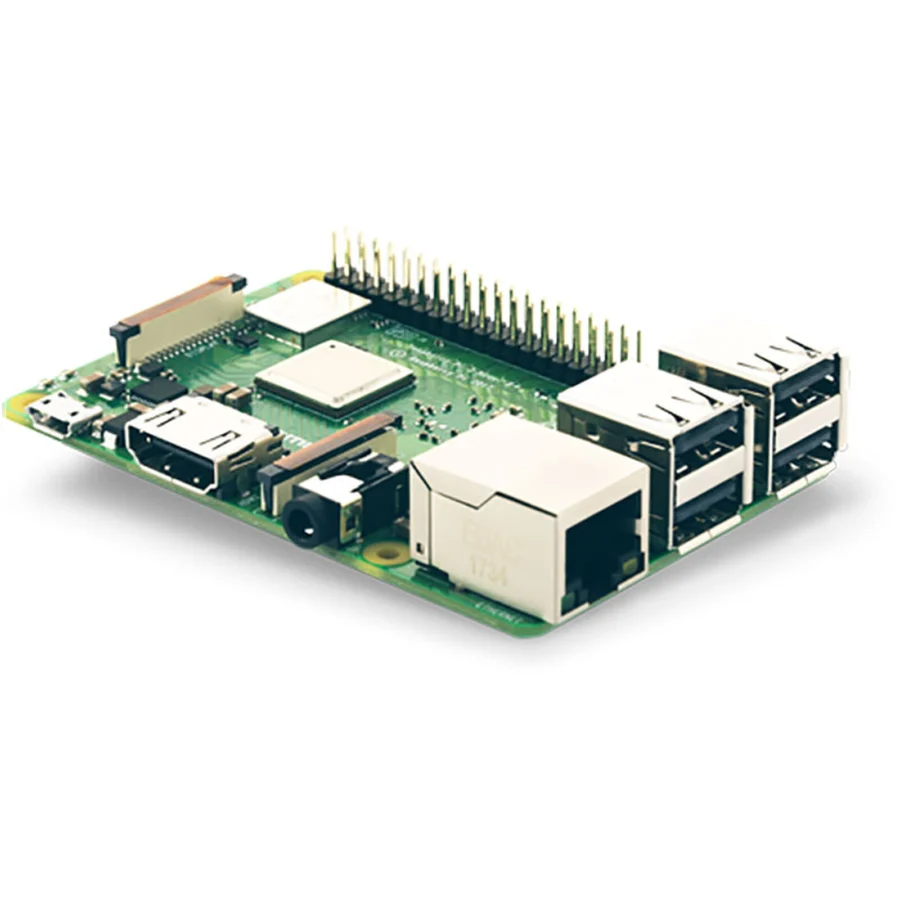
Un Raspberry Pi 3B+, dédié à la collecte de métriques, au monitoring de disponibilité, et à mon NAS personnel. Ressources limitées (1 Go de RAM), donc rôle volontairement restreint à des tâches de scraping léger, de stockage réseau — pas de calcul lourd ni d’interface graphique dessus.
Un Raspberry Pi 4B (nom d’hôte hub01, plus de RAM disponible), qui héberge toute la couche de visualisation : Grafana et mon dashboard applicatif développé sur mesure.
Deux postes Windows sont intégrés à la supervision via des exporters dédiés, et l’accès depuis l’extérieur passe exclusivement par un tunnel VPN WireGuard — j’ai délibérément écarté toute exposition directe de service sur internet, au profit d’un tunnel chiffré point-à-point vers le réseau local.
La stack de collecte et de supervision
Prometheus + Node Exporter forment le socle de la collecte de métriques système (CPU, RAM, disque, uptime) sur les deux Raspberry Pi. Node Exporter expose ces métriques au format texte Prometheus, scrapées à intervalle régulier.
windows_exporter joue le même rôle côté PC Windows, exposant des métriques dans le même format — tout l’intérêt du standard Prometheus étant que le pipeline de collecte reste identique quelle que soit la source.
Uptime Kuma complète le dispositif côté disponibilité pure : sondes actives (ping, HTTP) sur chaque point clé du réseau, calcul de ratios de disponibilité glissants (24h / 30 jours / 1 an), et notifications Telegram en cas d’incident. Détail technique : Uptime Kuma expose lui aussi un endpoint /metrics au format Prometheus — je l’exploite donc directement en scraping plutôt que via son API REST classique, authentifié par clé API dédiée.
Grafana, alimenté par Prometheus, sert de couche de visualisation avancée (graphiques historiques, tableaux de bord détaillés) pour l’analyse fine des performances dans le temps.
WireGuard assure l’accès distant : tunnel VPN léger et moderne, choisi après comparaison avec une exposition web directe — le compromis sécurité/simplicité m’a semblé nettement meilleur.
Discord ferme la boucle côté notifications et suivi de projet : webhooks dédiés pour les alertes de disponibilité en temps réel, et pour la publication automatisée de l’avancement du projet.
Le dashboard maison : le cœur du projet
C’est la brique la plus ambitieuse : plutôt que d’utiliser un dashboard générique, j’ai développé mon propre frontend de supervision en Python/Flask, déployé en production via Gunicorn et géré comme un vrai service systemd (démarrage automatique, redémarrage en cas de crash).
Quelques choix techniques dont je suis content :
Scraping et parsing sur mesure : le backend interroge directement les endpoints /metrics de Prometheus et d’Uptime Kuma, et parse les métriques via des expressions régulières ciblées plutôt que d’utiliser un client Prometheus générique — plus léger, et j’ai un contrôle total sur ce qui remonte à l’affichage.
Calcul d’uptime « temps réel » maison : Uptime Kuma n’expose que des ratios de disponibilité en pourcentage, pas de durée continue. J’ai donc implémenté un mécanisme de suivi d’état : à chaque scraping, l’application compare le statut courant de chaque service à son état précédent (persisté dans un petit fichier JSON), et horodate chaque transition en ligne/hors ligne. La durée écoulée est ensuite formatée intelligemment (minutes → heures → jours selon l’ampleur).
Écritures atomiques : toute persistance sur disque (configuration du layout, état des services) passe par un pattern fichier temporaire + renommage atomique, pour éviter toute corruption en cas de coupure au mauvais moment — un réflexe qu’on prend vite quand on tourne sur une carte SD.
Interface entièrement réorganisable : le frontend s’appuie sur GridStack.js pour un système de blocs déplaçables et redimensionnables à la souris, avec persistance de la disposition. Les colonnes de chaque tableau (machines, services) sont elles aussi réordonnables individuellement, et tout est sauvegardé côté serveur.
Zéro dépendance externe pour l’essentiel : pas de base de données, pas de service tiers — la configuration et l’état vivent dans de simples fichiers JSON versionnés avec le code.
Où en est le projet — Roadmap complète
10 modules terminés sur 10.
| # | Module | Statut |
|---|---|---|
| 1 | Prometheus + Node Exporter | ✅ Terminé |
| 2 | Uptime Kuma — supervision de disponibilité | ✅ Terminé |
| 3 | Grafana — visualisation avancée | ✅ Terminé |
| 4 | Premier dashboard central (Dashy) | ✅ Terminé |
| 5 | windows_exporter — monitoring postes Windows | ✅ Terminé (poste principal) |
| 6 | Intégration calendrier | ✅ Terminé — finalement réalisé au sein du Module 9, via un flux ICS Outlook plutôt que l’intégration directe bloquée par Microsoft |
| 7 | VPN WireGuard | ✅ Terminé |
| 8 | Intégration Discord (alertes + suivi de projet) | ✅ Terminé |
| 9 | Dashboard personnalisé développé sur mesure | ✅ Terminé |
| 10 | Reconstruction du NAS domestique | ✅ Terminé |
🎉 Les 10 modules du projet NOC sont désormais achevés ! Détail complet du Module 9 (dashboard sur mesure) sur sa page dédiée.
Détails du projet
- Technologies / matériel utilisés
- Raspberry Pi 3B+, Raspberry Pi 4B, Prometheus, Node Exporter, Uptime Kuma, Grafana, WireGuard, Discord, Flask
- Dates
- 15/09/2026
- Budget approximatif
- 340€
Fiche mise à jour le 26/09/2026